
Gary Illyes de Google : L'IA a aggravé l'usurpation d'identité de robot
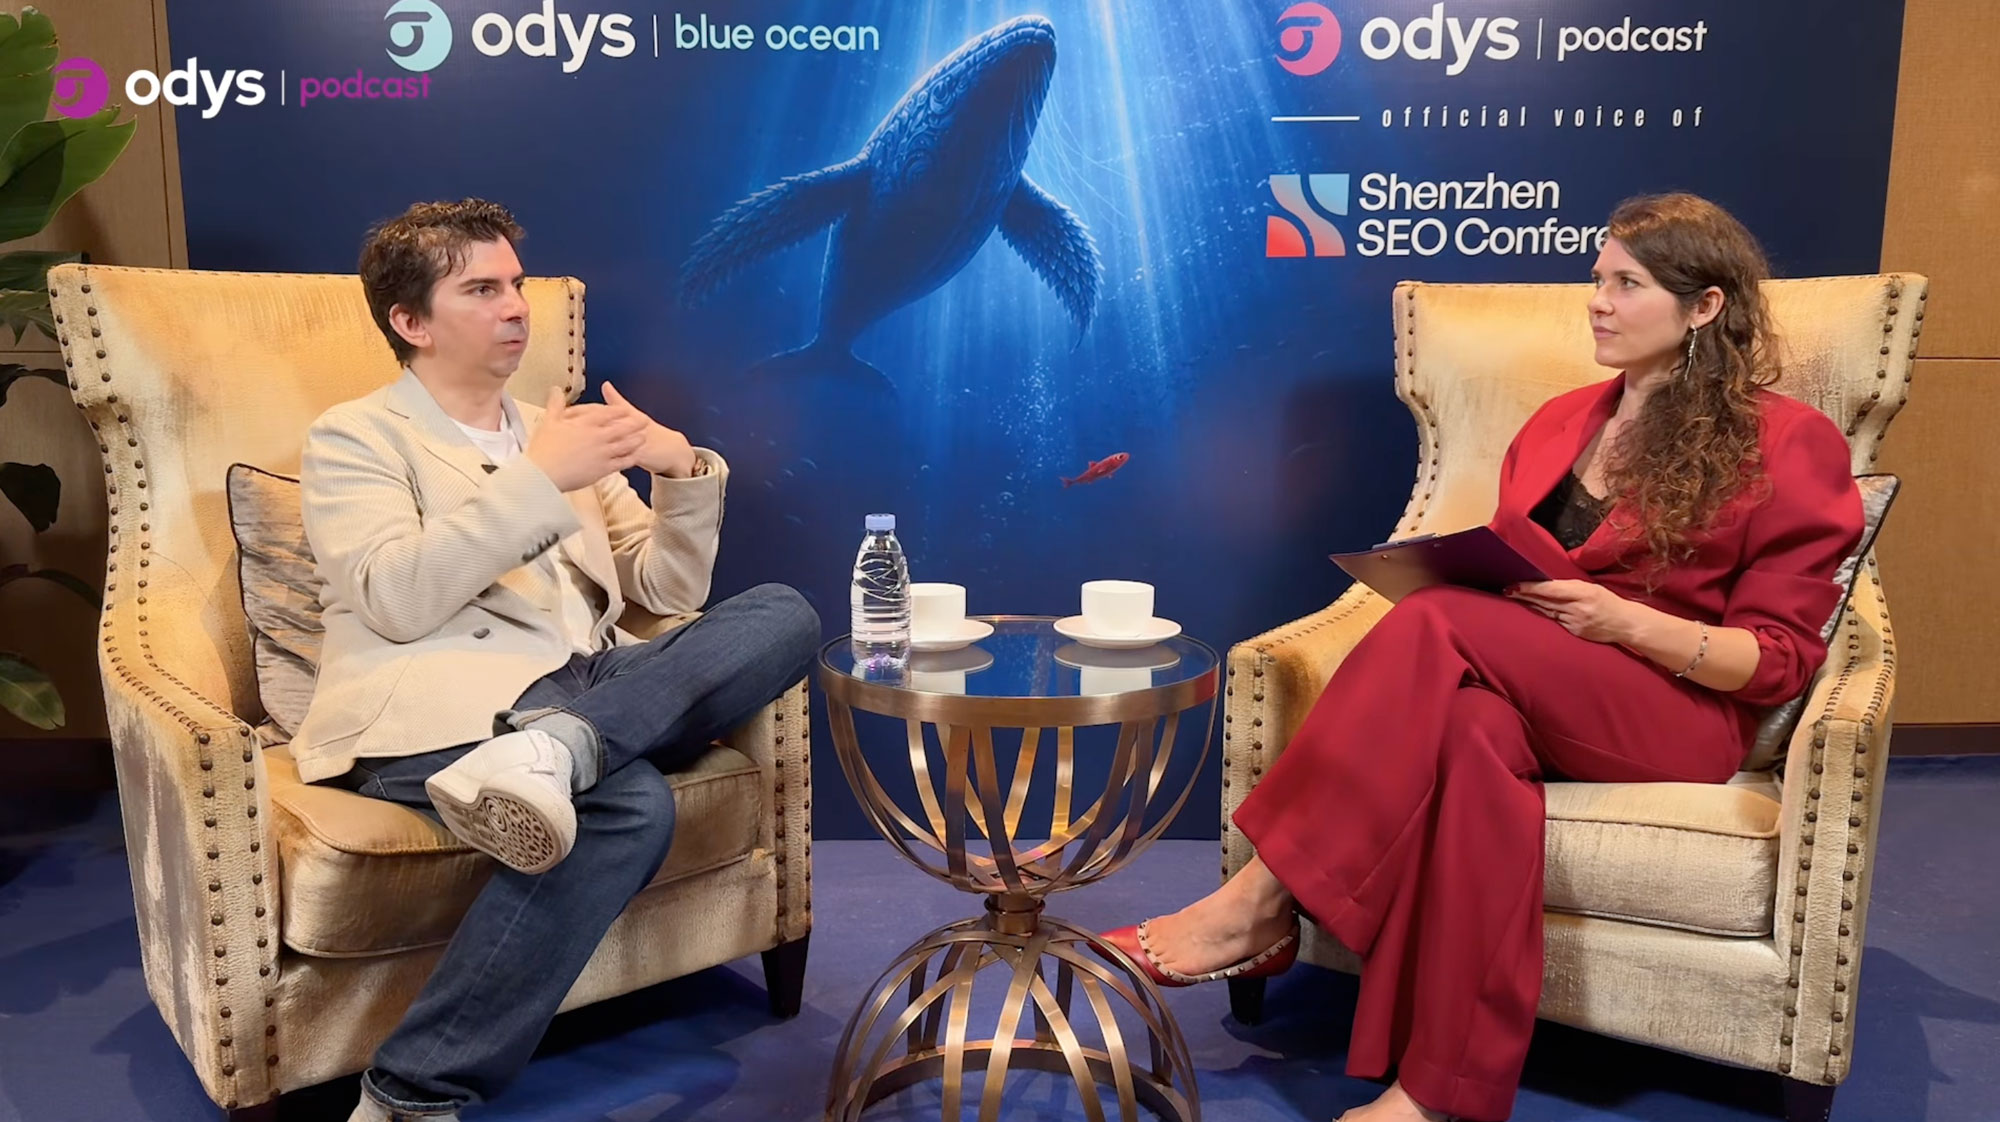
Gary Illyes de Google a été récemment interviewé par Aneta Samkoff, animatrice du podcast Odys. Le sujet concernait uniquement les robots et les robots d'exploration et ils couvraient beaucoup de terrain. Gary a déclaré que l’usurpation d’identité de robot est désormais plus problématique à cause de l’IA. L'usurpation d'identité d'un robot se produit lorsque des robots malveillants prétendent être quelqu'un qu'ils ne sont pas, comme se faire passer pour Googlebot.
Gary a déclaré : « Je pense que c'est l'IA », c'est la raison pour laquelle l'usurpation d'identité par un robot est devenue un si gros problème de nos jours. Il a déclaré : « Donc, fondamentalement, de plus en plus d'entreprises recherchent des jetons pour former leurs propres modèles, par exemple, et cela a besoin de contenu. Et l'idée est qu'Internet est une grande ferme où vous pouvez simplement sortir et récolter tout ce dont vous avez besoin. Et les pare-feu et les CDN en général se sont améliorés et identifient mieux ces robots d'exploration, mais ils ne sont pas parfaits.
La raison pour laquelle je pense que les gens usurpent l'identité d'un robot est que si vous utilisez un moteur d'IA plus petit ou si vous souhaitez supprimer un site, vous pouvez dire que vous êtes Googlebot et ils vous laisseront entrer. Sinon, vous pourriez être bloqué. Bien sûr, il existe d'autres moyens de vérifier si l'agent utilisateur est Googlebot, qu'il s'agit bien de Googlebot, par exemple par la vérification DNS inversée et les adresses IP.
Voici la vidéo :
Voici quelques-uns des points clés de cette vidéo :
- N'importe qui peut usurper l'identité de Googlebot en 30 secondes environ : modifier l'en-tête de l'agent utilisateur d'un robot est extrêmement simple. Illyes dit avoir mis en place des pots de miel en ligne qui attirent les robots d'exploration et trouvé des requêtes prétendant être Googlebot provenant d'adresses IP sans rapport avec Google. Les propriétaires de sites Web ne doivent pas faire confiance uniquement à un agent utilisateur de Googlebot. Ils doivent vérifier l’adresse IP et inverser les informations DNS.
- L’IA a fait de l’usurpation d’identité de robot un problème plus important : Gary Illyes attribue cette préoccupation croissante aux entreprises qui récoltent du contenu Internet pour former des modèles d’IA. Bien que les pare-feu et les CDN se soient améliorés dans la détection des faux robots d’exploration, ils ne détectent pas tout. Identifier qui explore un site Web aide les éditeurs à décider quel trafic autoriser.
- Les faux robots d'exploration peuvent submerger les sites Web et les mettre hors ligne : Google a passé des années à régler son infrastructure d'exploration pour éviter d'épuiser les ressources de son site Web. D'autres robots d'exploration peuvent ne pas disposer des mêmes garanties. Un robot mal configuré peut demander des URL à plusieurs reprises, consommer de la bande passante et des ressources du serveur et empêcher les visiteurs légitimes d'accéder à un site. Illyes affirme qu'une grande partie des dégâts actuels pourraient résulter de l'ignorance ou d'une mauvaise mise en œuvre plutôt que d'attaques délibérées.
- robots.txt n'est pas un mécanisme de sécurité : Gary Illyes décrit robots.txt comme une suggestion plutôt que comme une restriction exécutoire. Les robots légitimes le respectent généralement, mais les robots peuvent l’ignorer. Les propriétaires de sites Web qui doivent bloquer le trafic indésirable doivent utiliser des protections au niveau du réseau, telles qu'un pare-feu d'applications Web (WAF).
- Google sépare déjà l'exploration de la recherche de certaines utilisations de l'IA : les propriétaires de sites Web peuvent autoriser Googlebot à explorer les pages pour la recherche tout en utilisant le jeton robots.txt étendu de Google pour restreindre les utilisations éligibles du contenu à des fins de formation ou d'amélioration de certains modèles et services d'IA de Google. Illyes note qu'Apple dispose d'un jeton Applebot-Extended similaire. Il s’attend à ce que les contrôles d’accès pour différents types de clients automatisés deviennent plus précis.
- Les signatures cryptographiques pourraient rendre la vérification des robots plus fiable : Gary Illyes discute de Web Bot Auth, un effort impliquant des requêtes HTTP signées cryptographiquement. Plutôt que de s'appuyer uniquement sur les adresses IP ou les chaînes d'agent utilisateur, un site Web pourrait vérifier une signature par rapport à une clé publique pour vérifier si une demande provient véritablement de l'organisation revendiquée. Cela pourrait simplifier l’authentification, car les adresses IP deviennent plus difficiles et plus coûteuses à gérer.
- Les scores de réputation des robots sont un développement futur possible : Gary Illyes dit qu'il explore l'idée (il travaille avec les gens de robots.txt) d'un système de réputation pour les robots d'exploration, même si cela reste une idée à un stade précoce. Un tel système pourrait regrouper les commentaires des sites Web et des fournisseurs de sécurité sur le comportement responsable des robots. Il prévient qu’un système contrôlé par une seule entreprise pourrait introduire des biais.
- La plupart des petits sites Web n’ont pas besoin de s’inquiéter immédiatement des robots : son conseil est de déterminer si le trafic des robots pose réellement un problème avant d’investir dans des protections. Pour les sites qui ont besoin d’aide, un CDN doté de capacités de gestion de robots peut constituer un point de départ pratique. Les plateformes hébergées telles que Shopify offrent déjà des protections. Les sites plus grands ou plus populaires pourraient éventuellement nécessiter des contrôles plus sophistiqués.
Voici quelques mesures que vous pouvez prendre pour vous protéger contre les robots malveillants :
- Vérifiez correctement Googlebot : Vérifiez les plages IP publiées par le robot d'exploration de Google et inversez le DNS, plutôt que de vous fier uniquement à la chaîne de l'agent utilisateur.
- Surveiller les journaux du serveur : Recherchez les modèles d'exploration suspects, les adresses IP inattendues et les requêtes inhabituellement fréquentes.
- Utilisez un CDN ou un WAF : Appliquez des protections au niveau du réseau lorsque des robots indésirables menacent les performances ou la sécurité du site.
- Configurez le fichier robots.txt : Spécifiez quels robots d'exploration conformes peuvent accéder au contenu, tout en reconnaissant que les règles ne peuvent pas forcer les robots malveillants à s'y conformer.
- Séparez l’accès à la recherche de l’accès à l’IA : Lorsque cela est pris en charge, utilisez les directives spécifiques au robot d'exploration appropriées pour exprimer vos préférences concernant l'indexation et les utilisations du contenu liées à l'IA.
Pour plus de détails, consultez la documentation d'aide Qu'est-ce que Googlebot et comment vérifier les demandes de Googlebot.
Discussion sur le forum X.
